
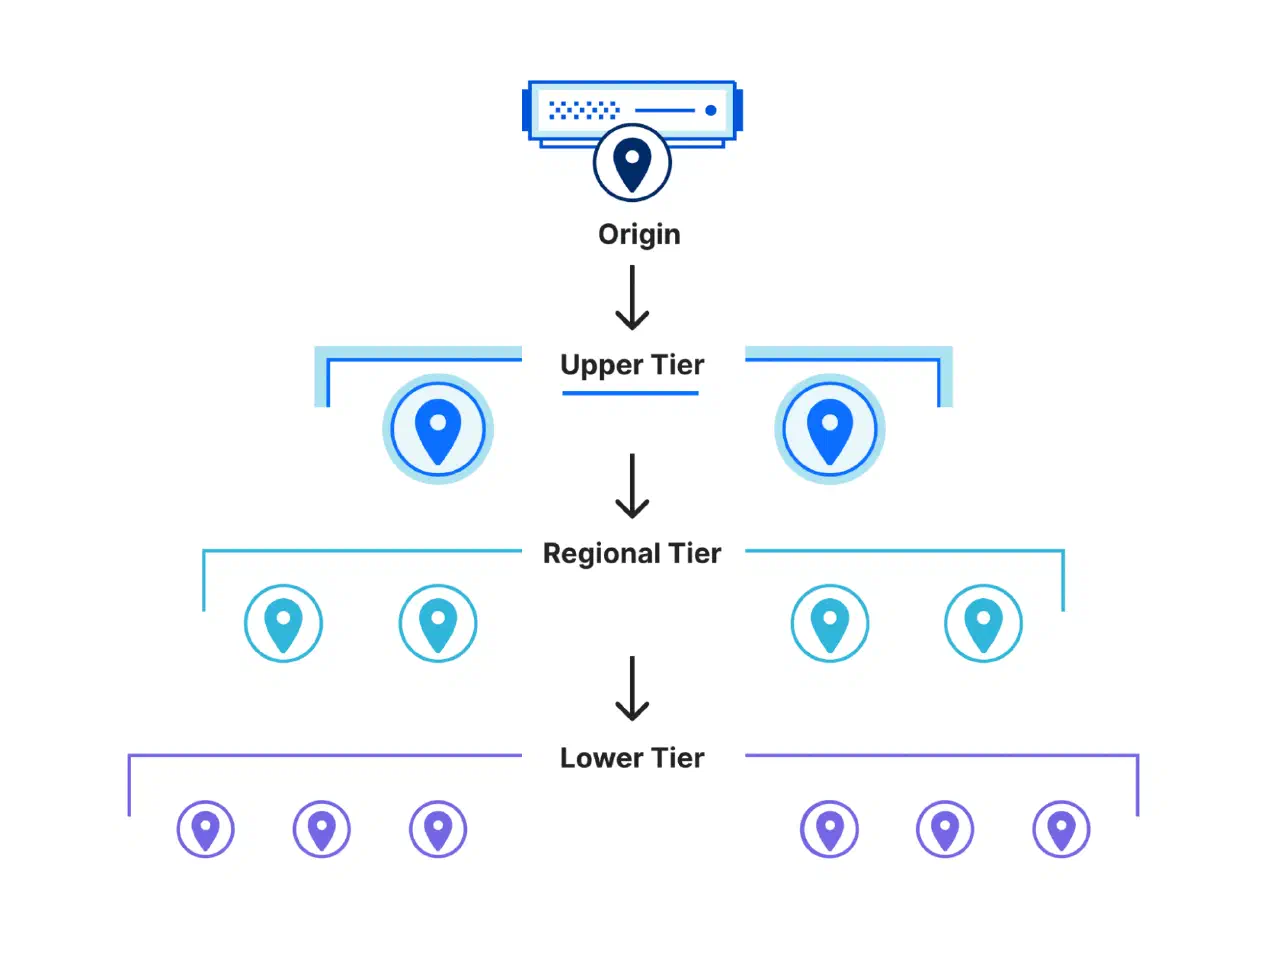
缓存命中率已经很高,接口为什么还是慢?因为“命中”只说明不用从最终数据源重新取值,不代表应用已经省掉代理、网络、连接等待和序列化。性能排查时,应该把一次缓存读取经过的路径画出来。
延迟同时取决于路径与命中位置#
缓存读取可以从两个方向改善:减少抵达缓存前的处理环节,以及让更多请求在靠近调用方的位置得到数据。Cloudflare 对 Workers KV 的一次优化就结合了缩短内部路径与分层缓存;这里不把它当时测得的加速幅度套用于其他系统。
无论使用 Redis 还是其他缓存,先定位等待发生在哪里,都比单纯追求一个更高的命中率更有帮助。同样是命中缓存,绕过一次不必要的远程调用与只减少几次服务端计算,带来的收益并不相同。
“命中了”还可以继续追问#
设想一个商品展示接口,先读取共享缓存,未命中时再查数据库。即使所有请求都命中共享缓存,应用也可能需要经历连接池排队、网络往返、服务端处理与结果解码。
可以为测试请求记录下面几段时间,字段名是可以的观测设计:
| 阶段 | 要回答的问题 |
|---|---|
| 等待连接 | 是否在客户端池中排队 |
| 请求往返 | 网络与服务端处理合计耗时如何 |
| 解码处理 | 大值或复杂结构是否增加开销 |
| 后续业务 | 缓存返回后还有多少工作 |
这些阶段不能随意相加重复计时。记录之前应明确每个时间点的边界,例如网络往返已经包含服务端处理,不能再把服务端耗时重复计入接口总时间。
如果仅看到 Redis 命令执行很快,却忽略了调用前的连接等待,就可能优化错对象。反过来,如果数据本身很大,减少一次网络跳转也不能解决全部解码和传输成本。
把总体命中率拆开看#
一个共享缓存的总体命中率,可以同时隐藏两种完全不同的请求:热点商品几乎每次命中,长尾商品经常回源。若只看平均值,少数慢请求带来的用户体验问题容易被大量热点请求稀释。
可以按请求类型、数据大小和业务入口分组,再分别观察命中与未命中的延迟。分组维度应保持有限,不要直接把每个用户标识都作为监控标签,否则观测系统本身可能难以维护。
比较不同时段时,还要检查流量构成。若优化后恰好更多请求访问热点数据,总体耗时下降可能来自样本变化。更可靠的比较,是在相近请求分布下分别看各类路径,再检查总体趋势,而不是只挑一张下降的平均耗时曲线。
多级缓存还需要区分命中位置。本地命中、共享缓存命中和数据库回源应该是不同事件,不能统称为一次“缓存成功”。这样才能知道优化是否真的让更多请求走了更短路径。
本地缓存减少往返,也增加副本#
Redis 客户端缓存可以把数据保存在应用侧,并通过服务端 Tracking 发送失效通知。具体支持与行为应按所用客户端确认;它不是给任意 GET 外包一层字典就自动成立的能力。
对于业务设计,可以先明确允许保留旧值的时间。例如商品介绍文本可能容忍短暂旧数据,库存扣减和账户余额则涉及不同要求。不能因为缓存都存键值,就把同一套过期策略用于所有数据。
增加应用实例后,同一份热点信息可能复制到更多进程,内存占用与失效处理也会变化。滚动发布中,新旧实例可能持有不同时间的缓存;验收不能只覆盖一台机器。
更新顺序需要围绕具体业务讨论#
假设后台修改商品说明,数据库写入成功,但缓存更新失败。此时接口仍可能返回旧内容。应该明确系统怎样观察和修复这一状态,而不是把一次写入异常隐藏在日志里。
可以记录数据版本、缓存填充时间与更新结果,以便排查读取的是哪一版。是否采用删除缓存、异步刷新或版本化键,需要结合更新频率和容错要求决定,不能从一个性能案例直接推导出通用写入方案。
对同一键的并发回源,也应检查是否产生重复数据库查询。合并同一进程内的重复请求,可以作为一种设计选择,但跨实例还涉及额外协调。应先证明回源量是瓶颈,再增加锁或其他机制。
为异常路径保留容量#
测试时至少覆盖正常命中、首次读取、失效后读取,以及共享缓存不可用。最后一种情况尤其值得观察:所有应用实例同时回源,是否会把压力集中到数据库?
测试目标不只是接口还能返回数据,还包括错误是否可识别、回源量是否有边界,以及恢复后是否重新填充正常。缓存恢复连接,不代表全部热点已经恢复,短时间内仍可能存在不同的延迟分布。
这些问题与站内缓存主题的关注点一致:性能与异常状态需要一起看。不能把“读取更快”理解成可以忽略超时、数据缺失与更新失败。
一致性限制决定适用场景#
Workers KV 采用最终一致性,其他位置可能需要等待才能看到更新,甚至“不存在”的查询结果也会缓存;对需要原子操作或单事务读写的场景,它并非理想选择。
因此,理解缓存的性能工程方法,与选择某个产品作为业务存储是两项判断。后者需要匹配写入频率、数据可见性和事务要求。不能因为读延迟表现好,就把它当作强一致数据库的替代品。
怎样把优化结论交给下一个维护者#
一份有用的记录应包含测试流量、数据大小分布、缓存状态、部署拓扑和异常结果。若优化仅缩短了热点读取路径,就明确写热点场景;若冷读没有改善,也应保留结果。
再把优化前后的调用路径放在一起,标出减少了哪次等待或哪段处理。这样其他人能够理解收益来源,而不是只看到一个百分比。若以后网络位置、实例数量或数据规模变化,也能据此决定需要重测什么。
缓存性能最终是路径问题、负载分布问题和状态一致性问题的组合。把三者拆开观察,再围绕真实瓶颈修改,才更容易得到稳定且可解释的收益。
参考来源#
- Thomas Gauvin、Rob Sutter、Andrew Plunk,《We made Workers KV up to 3x faster — here’s the data》,Cloudflare,2024-09-26。
- Cloudflare,《How KV works》,官方动态文档。
- Redis,《Client-side caching reference》,官方参考文档。
- 配图:Thomas Gauvin、Rob Sutter、Andrew Plunk / Cloudflare,图片出处。