
一条统计查询耗时很长,看到数据库还有空闲 CPU,容易想到增加并行工作进程。但决定收益的,不只是 CPU 数量,还有查询中可并行的部分、数据读取能力、中间结果大小,以及同时运行的其他请求。
并行适合分摊足够大的工作#
PostgreSQL 可以把查询中的部分工作交给多个进程处理。对于分析型查询,扫描与计算可能因此得到分摊;但创建进程、传递和汇总数据也有成本。并行不能替代合适的查询和索引设计,也不存在按 CPU 数量换算出的通用最佳进程数。
下面以 PostgreSQL 16 为例,部署配置可以参考站内PostgreSQL 16 部署笔记。
先判断慢查询属于哪一种#
假设商品系统有两种查询:按主键查一条商品,以及按整月明细统计各分类数量。前者更需要检查是否走对访问路径;后者才更可能包含足够大的可分摊工作量。
如果查询仅返回一条数据,却读取了大量无关记录,先检查过滤条件与索引通常比讨论并行上限更有针对性。若统计确实需要扫描大范围明细,则可以继续观察计划是否包含并行节点。
还要把数据库执行与接口总耗时分开。连接池等待、结果序列化和向客户端传输,都可能让接口看起来慢。仅优化 SQL 内部的一段时间,未必能显著改变用户等待。
执行计划告诉你工作怎样分配#
以一条按月统计分类数量的查询为例:
EXPLAIN
SELECT category_id, count(*)
FROM demo_order_items
WHERE created_at >= TIMESTAMP '2024-07-01 00:00:00'
  AND created_at < TIMESTAMP '2024-08-01 00:00:00'
GROUP BY category_id;
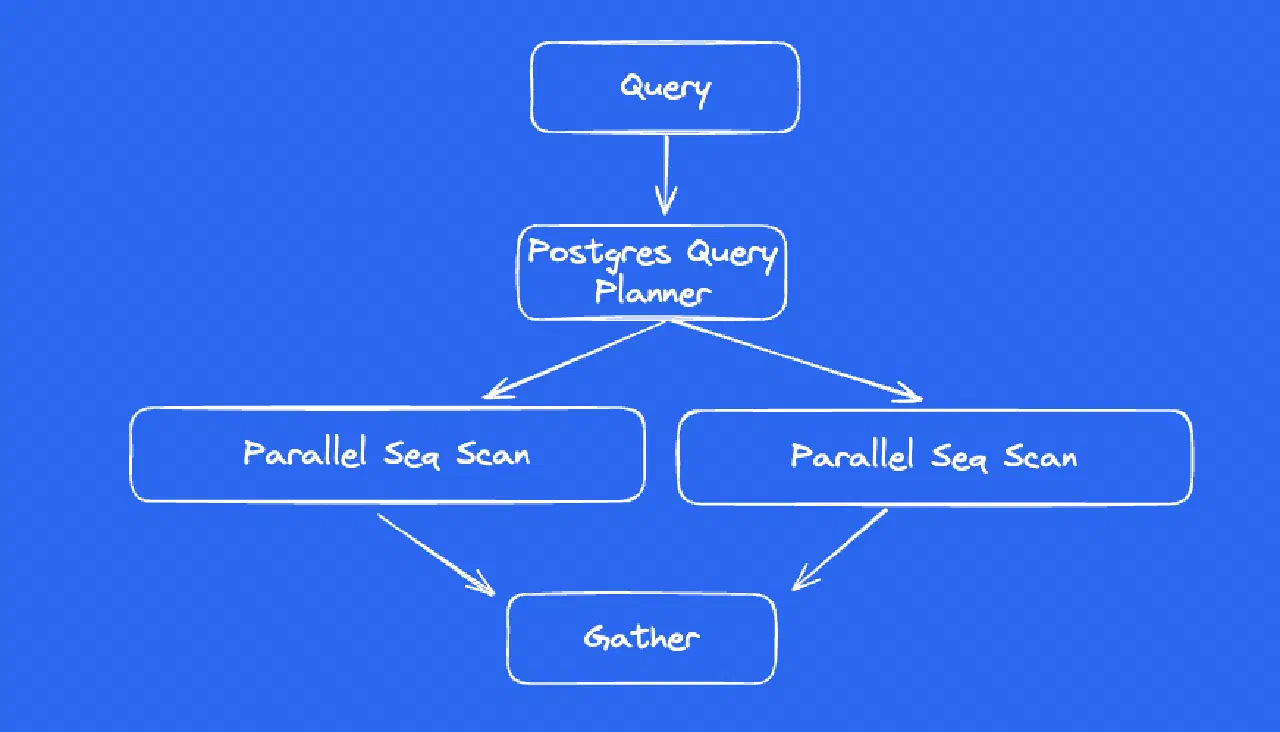
可以重点辨认 Gather、并行扫描及部分聚合等节点。并行计划仍需收集、合并结果;如果很多工作最终留给主进程,单纯增加下方工作进程也有边界。
观察实际计划时,区分计划安排的工作进程数与实际启动数。后者不足,可能是运行时没有足够可用进程,不能只据配置上限推断执行过程。对计划中不存在的字段也不要凭经验补数值。
三个上限不能混成一个参数#
PostgreSQL 16 区分了后台进程池上限、全局并行工作进程上限,以及单个 Gather 或 Gather Merge 节点上限,分别对应 max_worker_processes、max_parallel_workers、max_parallel_workers_per_gather。
可以先用只读查询了解现状:
SHOW max_worker_processes;
SHOW max_parallel_workers;
SHOW max_parallel_workers_per_gather;
SHOW work_mem;
max_worker_processes 只能在服务器启动时设置,不能通过普通 SET 把它当作会话级实验参数调整。需要变更时,应按运行平台的配置与重启流程处理。
这些参数规定允许的范围,不承诺每条查询都采用并行计划,也不预留足够的 CPU。对于共享数据库,应先确认整体负载和资源限制,再讨论上限是否适合。
内存不是“每条 SQL 只占一个 work_mem”#
work_mem 针对排序或哈希等操作,复杂查询可能同时包含多项操作;并行执行还会放大多个进程的资源消耗。哈希操作另受相应倍数控制。
这意味着用“连接数乘一个 work_mem”无法准确描述所有查询的最坏情况。即使客户端连接数没变,每条请求中的执行结构也可能改变内存压力。
以一组纯假设场景说明:一个后台报表原本偶尔运行,后来每个管理页面刷新都会触发它。即使单条报表变快,多个报表同时运行也可能压缩正常接口的资源。资源评估必须看并发和请求来源,不能只优化一次手工执行。
用同样数据做可比较的实验#
建议在隔离测试环境固定数据集、查询条件和统计信息,再比较少量不同并行配置。每次只改变一个因素,记录查询耗时、计划结构、CPU、磁盘读取和内存表现;不要同时升级数据库、修改索引和更换机器后,把全部收益归给并行。
冷缓存与热缓存应分别记录。第一次需要大量读盘,第二次数据已经在缓存中,这两次耗时不能简单用来证明参数效果。重复次数和运行顺序也应留在实验记录里。
还应保留查询的结果口径。性能实验前后,时间过滤、时区与分组条件不能悄悄改变。如果原先统计整月、新查询只统计一周,耗时下降也不能证明执行方式更优。先保证返回结果的业务意义一致,再比较资源与时间。
数据规模需要接近目标场景。几百行测试数据可能根本没有采用并行计划的必要,即使调整参数也无法模拟大表扫描。可以使用脱敏或合成数据,但应说明行数、分布和字段特点,避免把小样例的执行方式当作生产结论。
带 ANALYZE 的 EXPLAIN 会真实执行查询。即便是只读查询,也会消耗资源;检查写操作时更不能把它当成无副作用的预览。示例先使用普通 EXPLAIN,不要求在生产执行分析。
单条查询变快之后,再看其他请求#
可以把验收分成两项:报表自身的完成时间,以及报表运行期间正常接口的延迟与错误率。只有前者改善、后者明显退化,不能算整体优化完成。
若业务同时需要高频在线请求与大范围统计,可以继续评估报表调度、结果预计算或读负载隔离。但这些方案有各自的数据时效和运维成本,应从真实需求出发,不能因为出现一次慢查询就立即拆系统。
实验结论也应带条件,例如“在这组数据和并发下改善”,而不是“工作进程设为某个数就最快”。把计划与配置快照一同保存,后续数据分布变化时才有比较依据。
应用连接池也需要一起观察。一次大查询执行变快,不代表等待连接的请求一定减少;如果后台任务数量同时增加,连接池可能仍然排队。应把数据库计划、应用连接等待和接口耗时对齐到同一时间段,才能判断瓶颈是否真的移动。
以实际执行计划为准#
这里以 PostgreSQL 16 为例。使用其他大版本时,应查看相应版本文档及真实执行计划;容器中的 CPU、内存限制也需要单独确认。
对于业务性能排障,优先回答三个问题:工作是否真的能分摊,资源是否足够,以及分摊后有没有把代价转移给其他请求。这比直接套用“CPU 数量的一半”更容易得到能交付、能维护的结论。
参考来源#
- Elizabeth Christensen、Greg Smith,《Parallel Queries in Postgres》,Crunchy Data,2024-07-08。
- PostgreSQL Global Development Group,《Parallel Plans》、《Resource Consumption》、《Using EXPLAIN》,16 系列官方文档。
- 配图:Elizabeth Christensen、Greg Smith / Crunchy Data,图片出处。