
Redis 的内存占用,不等于业务字段值的总长度。即使每条记录只保存几个很短的状态值,键名、字段名、内部编码和内存分配方式叠加起来,也可能占据相当一部分空间。
如果缓存里有大量结构相近的对象,优化数据组织往往比单纯缩短过期时间更值得先检查。前者可能降低单条记录成本,后者则会改变缓存命中和数据库回源行为,二者解决的不是同一个问题。
为什么结构相同的对象值得关注#
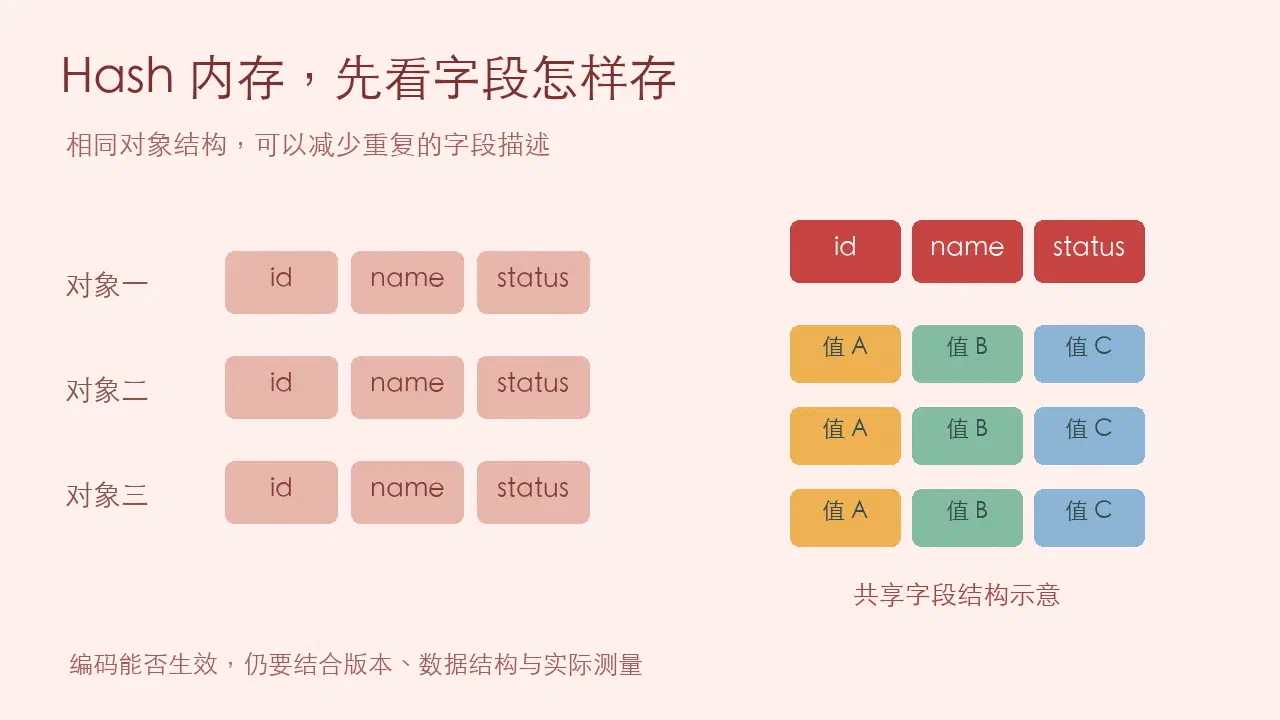
假设缓存十万条商品状态,每条都使用 status、region、tier 三个字段。字段值各不相同,字段名字却反复出现。能否减少这些重复结构,就是紧凑表示需要解决的问题之一。
Redis 8.10 引入的 Hash 模板,针对的是大量 Hash 共享稳定字段集合的场景:字段结构可以复用,各对象仍保留自己的值。它与简单地把几个命令合并成一次请求不同,关注的是内部存储组织。
这类优化有适用条件。对象之间字段差异很大,或字段集合频繁变化时,就不能套用相同的收益预期。官方给出的最高节省比例也属于特定工作负载,并不等于把现有服务升级后,整体进程内存就一定下降一半。
Hash、JSON 与独立键先按访问方式选择#
| 表示方式 | 常见适用场景 | 需要额外考虑 |
|---|---|---|
| 一个对象对应一个 Hash | 经常只读写某几个字段 | 字段集合、内部编码和对象级过期 |
| 一个对象对应一个 JSON 字符串 | 经常整体读取,字段层次较复杂 | 局部更新可能需要读改写 |
| 每个字段使用独立键 | 字段确实需要独立生命周期 | 键数量、命名和多字段一致性 |
选择数据结构时,先看业务怎么访问数据。为了节省几个字节,把一次完整读取拆成很多独立键,可能增加网络往返和一致性处理;反过来,把所有内容塞进一个大对象,也可能让小更新变得昂贵。
还要考虑缓存的恢复来源。如果数据能从数据库重建,失效后的回源路径应当清楚;如果 Redis 保存的是唯一状态,就不能简单按照普通缓存的淘汰方式处理。
内部编码不是应用层协议#
同样调用 HSET,不同大小、不同字段长度的对象,可能使用不同内部编码。应用应依赖命令定义的语义,而不是依赖某个编码名字永远不变。
可以在独立测试实例中建立一条虚构记录,再观察它的编码与内存占用:
redis-cli HSET demo:profile:1 status active region cn tier standard
redis-cli OBJECT ENCODING demo:profile:1
redis-cli MEMORY USAGE demo:profile:1这组命令用于理解观察方法,不包含预先编造的输出。OBJECT ENCODING 的结果会受到版本和数据内容影响;MEMORY USAGE 返回的是该键相关内存的估算,而不是整个进程的资源占用。键不存在时,也不能把空结果当作零字节的有效样本。
对复杂嵌套值,MEMORY USAGE 的采样设置会影响测量成本与精度。比较前应固定方法,避免一边采用默认采样,另一边遍历全部元素,再把差异全部解释成编码改进。
做容量估算时,先说清计算范围#
假设每条记录的字段值合计只有 60 字节,十万条的字段值总量约为 600 万字节。这只是值本身的数量级,还没算键名、字段名、对象结构、分配开销和运行缓冲。
| 估算层次 | 包含内容 | 可以怎样使用 |
|---|---|---|
| 业务载荷 | 实际字段值 | 理解最低数据量 |
| 键级测量 | 键及相关数据结构 | 比较代表性记录 |
| 实例级测量 | 整体数据和运行开销 | 规划容量与余量 |
| 业务级验证 | 访问延迟、回源和恢复 | 判断优化是否值得上线 |
不能拿字段值的理论大小去承诺实例内存,也不能只测一条最小对象,就乘以全部记录数。真实数据往往存在长字段、可选字段和异常大对象,应按分布抽取样本。
用代表性数据比较,而不是只跑导入速度#
可以准备三组数据:字段集合固定的普通记录、存在可选字段的记录、少量字段特别长的记录。分别记录导入后的总量、键级抽样和实例内存,再运行实际常见的读写操作。
测试时应固定版本、持久化设置、数据量和客户端并发。一次只改变一个主要变量,才能判断差异来自结构、编码,还是测试环境本身。
如果采用批量加载,还需要区分网络传输成本和服务端存储成本。减少往返可能提高导入吞吐,但不能据此证明稳态查询一定更快。应用实际更关心的,可能是高峰查询延迟和更新失败后的恢复方式。
Redis 8.10 的新命令和转换能力,应在目标版本上单独核对。已有服务不应因为看到新的节省比例,就直接在旧实例上执行新命令,或在没有回退方案时批量转换数据。
内存省下来了,还要看淘汰与回源#
缓存容量变化会影响淘汰频率。减少单条记录占用,可能让更多热点数据留下;但整体效果还取决于过期策略、访问分布和数据库承载能力。
例如缩短 TTL 后,Redis 的内存曲线更低,数据库查询却同时增加,接口延迟也可能上升。这并不意味着“优化成功,只是数据库需要扩容”,而应先检查是否把成本转移到了回源路径。
对于使用复制和持久化的实例,还需为相关缓冲和后台操作预留空间。maxmemory 不是容器或主机所有内存的总预算,不能把限额刚好设置成宿主机可用内存后就认为不会发生资源问题。
可以结合已有的缓存穿透、击穿和雪崩笔记一起看:数据结构、容量、失效和恢复,最终都需要服务于同一条业务请求链路。节省内存有价值,但优化的完成标准应包含业务仍然正确、延迟符合要求,以及异常时能够恢复。
参考资料#
- Bosmat Tuvel、Lior Kogan:Announcing Redis 8.10: Compact Hash, JSONPath extensions, performance improvements, & more,2026-09-14。
- Redis:HSET、OBJECT ENCODING、MEMORY USAGE。
- Redis:Bulk loading、Key eviction。