
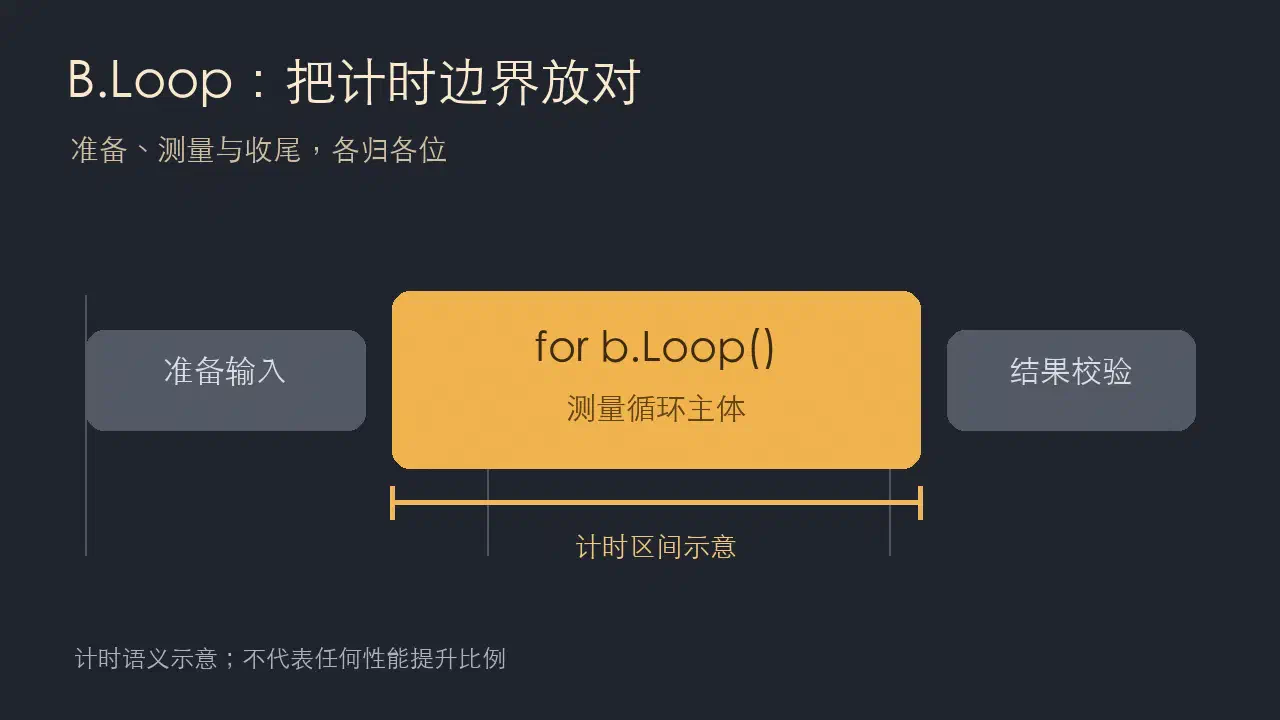
把一个函数放进循环,得到一个很小的 ns/op,并不代表优化有效。测量可能混入了准备数据的时间,也可能让编译器消除了真正想测的操作;即使计时没错,输入不符合业务,数字也难以指导决策。
Go 1.24 新增的 testing.B.Loop 简化了基准测试的常见结构。理解它的计时边界之后,还需要继续回答输入是否合理、结果能否比较,以及局部优化对完整请求意味着什么。
B.Loop 怎样管理计时#
使用 for b.Loop(),基准测试框架会管理循环外的准备和清理计时,并减少无意编译优化造成的误测。相比传统 b.N 写法,常见的基准结构更容易写对。
循环内若仍有每轮准备工作,就要自己决定哪些成本应计入。计时起点与终点应由要测量的业务步骤决定。
先写一句话:这次到底测什么#
假设服务需要把查询结果编码成 JSON。有三个看似相近的问题:编码已有对象需要多久;构造对象加编码需要多久;一次完整 HTTP 请求需要多久。它们应有三份不同的测量。
第一份可以在循环外准备对象,只测编码;第二份应把对象构造放进循环;第三份还会包含中间件、路由、网络与客户端等成本。若把第一份命名成“接口性能”,读者就很容易误解其覆盖范围。
因此,写基准前先用自然语言定义计时起点、终点和输入。函数名只能表达一部分意图,说明文字要把省略的环境交代清楚。
用请求编码定义测量范围#
下面示例面向 Go 1.24 及后续版本,测量一个已准备好的对象被编码为 JSON 的成本。
package benchdemo

import (
    "encoding/json"
    "testing"
)

type QueryResult struct {
    ID     string   `json:"id"`
    Labels []string `json:"labels"`
}

func BenchmarkEncodeResult(b *testing.B) {
    input := QueryResult{
        ID:     "example-001",
        Labels: []string{"ready", "local"},
    }
    b.ReportAllocs()

    for b.Loop() {
        encoded, err := json.Marshal(input)
        if err != nil {
            b.Fatal(err)
        }
        if len(encoded) == 0 {
            b.Fatal("编码结果为空")
        }
    }
}
对象准备在循环外,编码及错误检查在循环内。这里测到的也包含长度检查等少量开销,因此它是一个完整测试体的测量,不能不加判断地把每个纳秒都归因给编码器内部。
示例在 Go 1.25.11、macOS arm64 环境通过编译和单轮基准运行。性能比较仍需按后面的步骤采集多次样本。
ReportAllocs 帮助观察每次操作的内存分配。分配减少可能有价值,但需要结合整体调用频率和对象生命周期判断,不应为了少一次分配而引入难以维护的共享可变状态。
B.Loop 的保护范围要读准确#
循环必须采用 for b.Loop() { ... } 形式;编译优化保护有明确的语法范围,被调用函数内部仍正常优化。同一个基准使用 Loop 或 b.N 中的一种方式,不能混用。
实践中没有必要为了少写几个字符,把它包成自定义循环帮助函数。直观的写法更便于审查,也能让读者一眼看清计时范围。
此外,调用量应由框架控制。不要在循环里根据当前次数换成越来越简单的输入,这会把不同工作量揉成一个平均值。要比较多种规模,分成有名字的子基准更容易解释。
输入要能代表真正关心的路径#
对于上面的编码器,至少可以考虑短字段、长文本、空列表和多条标签等情况。它们不是为了凑覆盖率,而是为了防止“短对象快了,真实大对象反而慢了”被一个总数字掩盖。
如果被测操作会修改输入,还要防止后续循环复用已处理的状态。例如压缩、去重和排序都可能让下一轮输入发生变化。每轮是否重建数据、重建时间是否计入,都应该与测量目标一致。
| 设计选择 | 对应的问题 | 报告中应说明什么 |
|---|---|---|
| 输入在循环外固定 | 已有对象的处理成本 | 输入形状与大小 |
| 输入在循环内构造 | 完整计算步骤的成本 | 构造是否属于业务路径 |
| 多规模子基准 | 不同负载下的变化 | 每种规模单独比较 |
不确定某个准备操作应放哪里时,可以同时保留“核心操作”和“完整步骤”两份基准。差异本身能帮助定位成本,前提是命名准确。
怎样比较多次运行结果#
benchstat 可以生成 Go 基准结果的统计摘要与前后比较。每项至少运行十次收集样本,有助于观察测量波动;统计显著与业务价值大小则应分别判断。
下面命令用于采集前后两组结果,需在包含上述文件的模块目录执行,并预先安装适用版本的 benchstat。
go test -run='^$' -bench='BenchmarkEncodeResult$' -benchmem -count=10 > before.txt
# 修改实现后,在相同环境再次运行
go test -run='^$' -bench='BenchmarkEncodeResult$' -benchmem -count=10 > after.txt
benchstat before.txt after.txt
记录工具链、处理器、操作系统、相关参数和提交版本。笔记本处于电池模式、后台同时运行构建任务,或者两组结果来自不同机器,都可能让对比变得难解释。
在长期维护的项目里,基准输入也应随代码保存。当接口字段、序列化选项或数据规模发生变化时,记录这些变化,避免新旧结果看似同名却处理了不同内容。
不要挑选最快的一次和修改前最慢的一次比较。保留全部样本,同时检查正确性测试,才容易在后续复查时发现误测或语义变化。
什么时候该停止微观优化#
若某段编码只占请求耗时很小一部分,局部加速未必能改变用户体验。反之,高频调用里的稳定分配降低,可能在整体负载下产生意义。基准用于回答局部成本,系统分析还要查看真实路径中的等待、并发和资源使用。
例如,一次接口请求同时包含编码与数据库等待,即使编码时间明显下降,也不能直接推导完整接口延迟按相同比例下降。负载变化还会影响排队和并发资源使用;微基准的每次操作耗时与线上请求的尾延迟,属于不同观察对象。
在代码评审里,可以把优化说明写成“在某种输入下,某个操作的时间与分配如何变化”,同时附环境和样本。若只能得到不稳定的小差异,明确写出证据不足,也比给出一个缺乏依据的加速百分比有用。
一个可操作的顺序是:先确认热点,再建立代表性基准,修改后验证正确性,最后比较多次结果。若数字的变化无法解释,先检查测量边界和环境,而不是立刻把优化写进结论。
参考来源#
- Junyang Shao:More predictable benchmarking with testing.B.Loop;发布:2025-04-02。
- Go 项目:testing,Go 1.24.0。
- Go 性能工具项目:benchstat。