
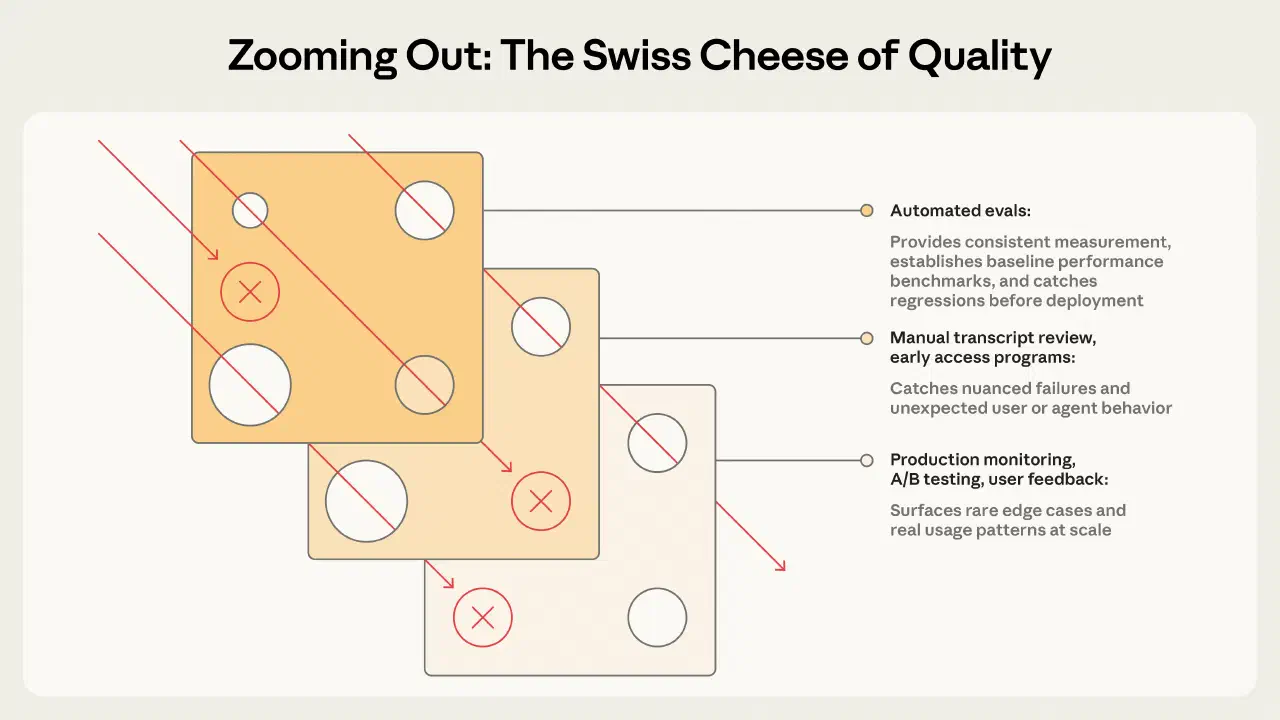
一个 AI 助手能够回答“订单已经查到了”,和它确实查对了用户、订单及状态,是两件需要分别验证的事。开发 Agent 时,最容易缺少的不是新的提示词,而是一套能发现退步、解释失败的验收方法。
一套有效的评估应同时检查结果和过程:回答是否有事实依据,工具是否按规则执行,结束后的业务状态是否正确。
一次评估需要记录哪些信息#
一次评估可以拆成任务、单次尝试、评分器、运行记录和最终环境状态。Agent 会调用工具并改变状态,因此评分不能只阅读最后一句回答,还要确认任务是否真正完成。代码检查、模型评分和人工判断各有适用范围,模型评分需要与人工判断校准。
“偶尔能够完成”和“多次稳定完成”也要分别衡量:允许多次尝试后至少成功一次,与要求每次都成功,衡量的是不同能力。评估记录应当支持检查失败原因,而不能只留下一个总分。
单元测试与 Agent 评估分别解决什么#
假设要做一个订单查询助手。底层工具接受订单号,返回结构化数据;上层 Agent 决定何时调用、是否需要追问,以及怎样把结果告诉用户。
单元测试可以验证工具函数:订单不存在是否返回明确错误、金额是否保留精度、超时是否被正确分类。Agent 评估则把用户请求送进完整系统,观察它是否选对工具、理解返回值并给出有依据的回答。
| 检查层次 | 订单助手中的检查对象 | 不能据此推导什么 |
|---|---|---|
| 工具单测 | 查询接口对不存在的订单返回约定错误 | Agent 一定会正确解释错误 |
| 工作流评估 | 用户描述不完整时,助手是否追问订单号 | 所有自然语言表达都已覆盖 |
| 端到端验收 | 对话结束后给出的状态与测试数据库一致 | 生产环境长期可靠 |
这些层次可以共享断言,但验收对象不同。工具全绿而对话失败,可能是模型误解业务;对话通过而工具单测失败,可能是样例恰好避开了缺陷。报告需要保留这种区别。
先把“成功”写成具体事实#
不要把题目写成“回答得友好、准确、专业”。可以把第一道题设计为:测试账号有订单 A,状态为待发货;用户询问订单 A;助手必须返回待发货,且不能把它说成已发货。
进一步增加几类题:同一用户存在多个订单、订单号缺失、订单不属于当前账号、查询超时、工具返回未知枚举。每道题都说明允许读取什么、成功结果是什么、遇到信息缺口应如何处理。
例如,订单归属不匹配的预期结果可以是“拒绝披露详情,并说明需要核对账号”。这里的成功是正确保留边界。若题库只有正常查询,模型即使永远返回一个看似完整的订单答案,也可能拿到很高分。
对于没有唯一表达的回答,把验收拆成事实项比匹配整句更合理:“状态等于待发货”可以自动检查;“是否清楚说明下一步”可以用明确的人工规则复核。不能因为句子和参考答案不同,就判定业务失败。
一个最小题目可以怎样记录#
可以用下面的 JSON 记录一条题目,接入评估框架时再编写适配代码:
{
  "case_id": "order-status-001",
  "fixture_version": "orders-v1",
  "request": "请查询订单 A 的发货情况",
  "expected": {
    "order_id": "A",
    "status": "pending_shipment",
    "write_count": 0
  },
  "limits": {
    "tool_calls": 4,
    "duration_seconds": 30
  }
}
fixture_version 标记测试数据版本;expected 约束结果;limits 约束资源。这里的次数与时限只是演示值,需要由产品目标决定。查询功能没有写操作,因此把 write_count 明确设为零。
真实评分器还应读取独立记录的工具事件及测试数据,不能直接相信 Agent 自报“调用了零次写接口”。证据来源也属于评估设计的一部分。
结果与过程分开审查#
对于上面的题目,结果检查可以核对订单号、状态和写入次数;过程检查则观察是否绕过必要的身份校验、超出工具调用预算,或者在超时后编造订单信息。
过程不必被固定成唯一脚本。只要权限允许、结果正确,先确认订单号再查询,或从已有上下文取得订单号后直接查询,都可能合理。需要强约束的是业务规则,而不是开发者第一次想到的工具顺序。
对失败进行分类也很有用:事实错误、权限边界错误、未完成任务、超预算、环境异常。不要让超时连接失败和回答编造混在同一个“错误率”里,否则修改提示词可能永远修不好基础设施问题。
重复试验要回答哪个问题#
假设一个简化情形:每次尝试彼此独立,单次成功概率固定为 80%。连续三次全部成功的概率是 0.8 × 0.8 × 0.8 = 51.2%;三次中至少一次成功的概率是 1 - 0.2³ = 99.2%。这只是概率演算,实际运行可能存在相关性,不能直接套用估算。
由此可以设计两份报告:一份记录首次尝试成功率,另一份记录固定重试策略下的成功率与成本。若允许重试,必须把重试次数、选择最终答案的方式和失败尝试一起保留。反复试到成功再只展示最后一次,会掩盖稳定性问题。
此外,题目之间难度不同,整体平均值可能遮住关键失败。例如普通查询通过率很高,但所有超时题都答错。这时按场景分组,比单独追求漂亮总分更能指导修复。
固定题集也要隔离环境#
固定题集的价值在于比较:模型、提示词或工具变更前后,面对的是同一组输入和初始数据。题集可以扩展,但每次比较都要注明版本,不能把换题造成的变化解释成能力提升。
pytest 的 fixture 支持按测试函数等范围创建与清理资源。对于会改变订单状态的题,可以借用这种生命周期思路,为每次试验准备独立测试数据,并在结束后清理。共享一个可变数据库会让后面的题读取到前面留下的结果。
Inspect 的评估集工具提供失败任务重试和运行日志管理能力。采用这类工具时,应区分基础设施失败后的续跑与主动给 Agent 的多次解题机会,并在报告中记录配置;两者不能混为同一个通过率口径。
第一版不必覆盖所有想象中的请求。可以先挑出产品中最常见的查询、几类高影响异常和最近发现的错误,为每类定义独立判据。只有当失败能够被复现、解释并加入回归题集时,评估才真正进入日常开发流程。
参考来源#
- Mikaela Grace、Jeremy Hadfield、Rodrigo Olivares、Jiri De Jonghe:Demystifying evals for AI agents,2026-01-09。
- pytest 项目:How to use fixtures。
- Inspect 项目:Eval Sets。
- 配图:Anthropic,图片出处。