
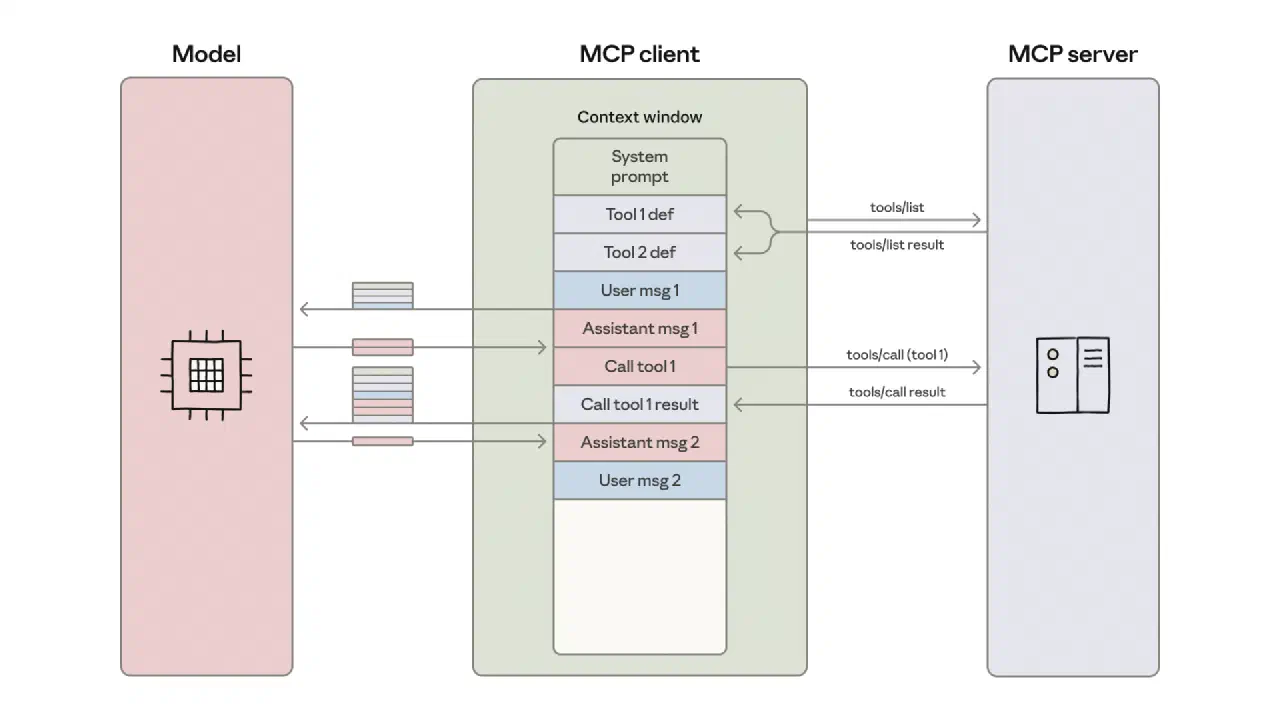
让 AI 查看大量构建记录时,逐条读日志并不总是合适。查总数、按状态分组、处理分页,这些有明确规则的工作可以交给代码;模型再依据统计结果解释现象、选择需要深入查看的异常记录。这样设计的关键,是减少无用数据,同时保留判断所需的完整性信息。
工具负责取数,代码负责确定性处理#
大量工具定义和反复传入模型的中间数据,都会增加开销。一种处理方式是让模型编写代码调用工具,在执行环境中完成分页、筛选和计算,再返回必要结果。MCP 负责连接工具,具体怎样编排调用,则由应用选择。
工具还可以包装成 TypeScript 接口,供执行环境调用。这样,循环和统计规则能够用普通代码表达,模型只需关注任务范围及结果解释;不过,应用也需要额外维护执行环境和错误处理。
从一个只读统计任务开始#
设想要回答:“某测试项目昨天的构建中,有多少失败,是否集中在某个分支?”第一步应确定项目和时间范围,并统一时间口径。否则,“昨天”可能分别被客户端和服务端理解成不同日期。
先定义一个只读的构建查询函数,输入项目、起止时间和分页游标,返回记录与下一页游标。这个接口需要由业务服务提供:
type Build = {
  id: string;
  branch: string;
  status: "success" | "failed" | "cancelled" | "running";
};

type BuildPage = {
  records: Build[];
  nextCursor: string | null;
};
设计中把取消、运行中和失败分开。如果直接把“非成功”都算成失败,统计会带入错误含义。是否需要把这些状态合并展示,应由问题定义决定,不能图方便就混算。
还应明确时间过滤针对构建开始还是结束。一个昨天开始、今天结束的任务,在两种定义下归属不同。这个问题没有统一答案,但一份统计必须采用一致定义并把它写进输出。
中间处理应留下可检查的结果#
代码可以负责翻页和计数,返回给模型的对象则应包含范围、完整性、各状态总量和少量失败样本。假设查询得到八条成功、两条失败和一条取消记录,可以返回这样的对象:
{
  "project": "demo-service",
  "timeBasis": "started_at",
  "complete": true,
  "counts": {"success": 8, "failed": 2, "cancelled": 1, "running": 0},
  "failedSampleIds": ["b-101", "b-107"]
}
模型可以据此说明有失败构建,但还不能认定原因,也不能回答是否集中于某分支,因为当前结构没有分支分组。缺什么就追加哪项统计,不应从两条样本推断整体分布。
完整性也不是装饰字段。如果只读取到前几页,complete 必须为 false,并附上中断原因。部分结果仍可用于查看样本,却不能伪装成整天的总数。
循环要有退出条件#
以下是围绕假设接口编写的简化逻辑,用于解释控制流。listBuilds 必须由实际客户端适配提供,不能直接复制运行:
const counts = { success: 0, failed: 0, cancelled: 0, running: 0 };
const seen = new Set<string>();
let cursor: string | null = null;
let complete = false;

for (let page = 0; page < 20; page++) {
  const result: BuildPage = await listBuilds({ ...query, cursor });
  for (const build of result.records) {
    if (seen.has(build.id)) continue;
    seen.add(build.id);
    counts[build.status]++;
  }
  cursor = result.nextCursor;
  if (cursor === null) { complete = true; break; }
}

return { counts, complete, nextCursor: cursor };
20 页只是示例上限,实际限制应根据查询规模和执行预算设置。实现中还要处理单次请求超时、重复游标、未知状态和服务限流;遇到异常时保留已处理页数,明确返回部分结果。类型声明只是开发约定,网络返回仍需校验,不能假设它天然符合 BuildPage。
按构建标识去重能避免重复记录被重复计数,但不能弥补分页期间的数据变化。若要求严格核对某个时刻的结果,需要服务端提供快照、稳定查询条件或可追溯导出,而不是仅靠客户端循环。
还有一个容易忽略的区别:查询失败与查询成功但没有记录,不应返回同样的空数组。如果权限不足、网络超时都被包装成“没有构建”,模型会给出貌似合理的结论。适配层应把这两类结果分开,让调用方知道是数据为空还是证据未取得。
恢复任务时,也不要只保存下一页游标。应同时保存项目、时间范围、过滤条件、已处理记录标识或可靠的统计状态。如果更换过滤条件后继续使用旧游标,得到的结果可能前半段属于一个范围,后半段属于另一个范围。不能恢复一致查询时,重新开始一次有明确标识的统计更容易复核。
用小数据验证统计规则#
接入真实服务前,可以在本地准备一组人工写出的分页结果:第一页两条成功,第二页一条失败,再重复第一页的一条记录。期望输出是三条独立构建,而不是四条。用这组数据检查去重与计数规则。
再准备一个第二页超时的案例,期望得到部分结果和未完成标记;准备未知状态的案例,期望报告协议数据不符合约定,而不是把它塞进成功计数。最后加入空记录页但仍有下一页的情况,确认程序依据游标判断结束,而不是把空页直接当作查询完成。
协议负责连接,业务仍要自己定义#
MCP 2026-07-28 工具规范定义了工具的输入模式与结构化结果,并说明跨调用状态应使用显式标识传递。应用包装可以利用这些信息,但不会自动获得正确的统计语义。
因此,构建游标是否过期、查询属于哪个项目、调用者是否有权访问,仍应由服务端检查。客户端拿到了一个游标,也不意味着它可以绕过项目权限。接入 SDK 时,还应核对客户端、服务端与协议版本的兼容关系。
如果工具本身支持按状态和分支聚合,优先考虑直接调用聚合接口。把所有记录下载后再本地计算会增加数据传输与分页一致性问题。只有服务端能力不足、需要跨数据源计算或临时转换时,代码执行层才更有必要。
少给模型数据,不等于数据自动安全#
执行环境仍然能接触原始记录,运行日志也可能保存它们。只向模型返回摘要,减少了进入对话的内容,却没有消除底层访问风险。
执行环境需要同时约束文件系统和网络访问。对于只读构建统计,可以只允许访问目标构建服务,不注入项目写权限,不挂载开发者主目录,并限制时间、内存与输出大小。
不要因为模型生成了一段“看起来只读”的代码,就把管理员凭据传进去。权限应围绕任务需要授予;如果以后要重跑失败构建,那是新的写入能力,必须重新设计调用范围和重复执行处理。
用相同问题比较两种实现#
在决定引入代码执行前,可以用同一组虚构记录比较直接工具调用与代码汇总:结果是否一致、分页是否完整、失败是否正确暴露、模型是否能引用具体构建标识。再记录实际请求耗时、输入量与维护成本,而不是只比较回答长度。
对于几条记录的一次查询,直接调用通常已经足够清楚。对于多页记录的稳定计算,代码更便于检查规则。最终选择应由任务规模和可维护性决定:少一次模型调用如果换来一个难以运维的执行服务,未必划算。
参考来源#
- Adam Jones、Conor Kelly,《Code execution with MCP: Building more efficient agents》,Anthropic,发布:2025-11-04。
- Kenton Varda、Sunil Pai,《Code Mode: the better way to use MCP》,Cloudflare。
- MCP 规范维护者,《Tools》,协议版本 2026-07-28。
- David Dworken、Oliver Weller-Davies,《Beyond permission prompts: making Claude Code more secure and autonomous》,Anthropic,发布:2025-10-20。
- 配图:Anthropic,图片出处。