
本地运行大模型时,经常会遇到这样的疑问:下载了一个 GGUF 文件,为什么另一个人可以运行,自己的电脑却不行?答案通常不只在文件大小,而在模型架构、推理引擎、硬件后端和运行参数的组合。
排查时先分层:文件能否读取,架构是否受支持,计算后端有没有生效,运行资源是否足够。不要把这些问题都归因于“模型太大”。
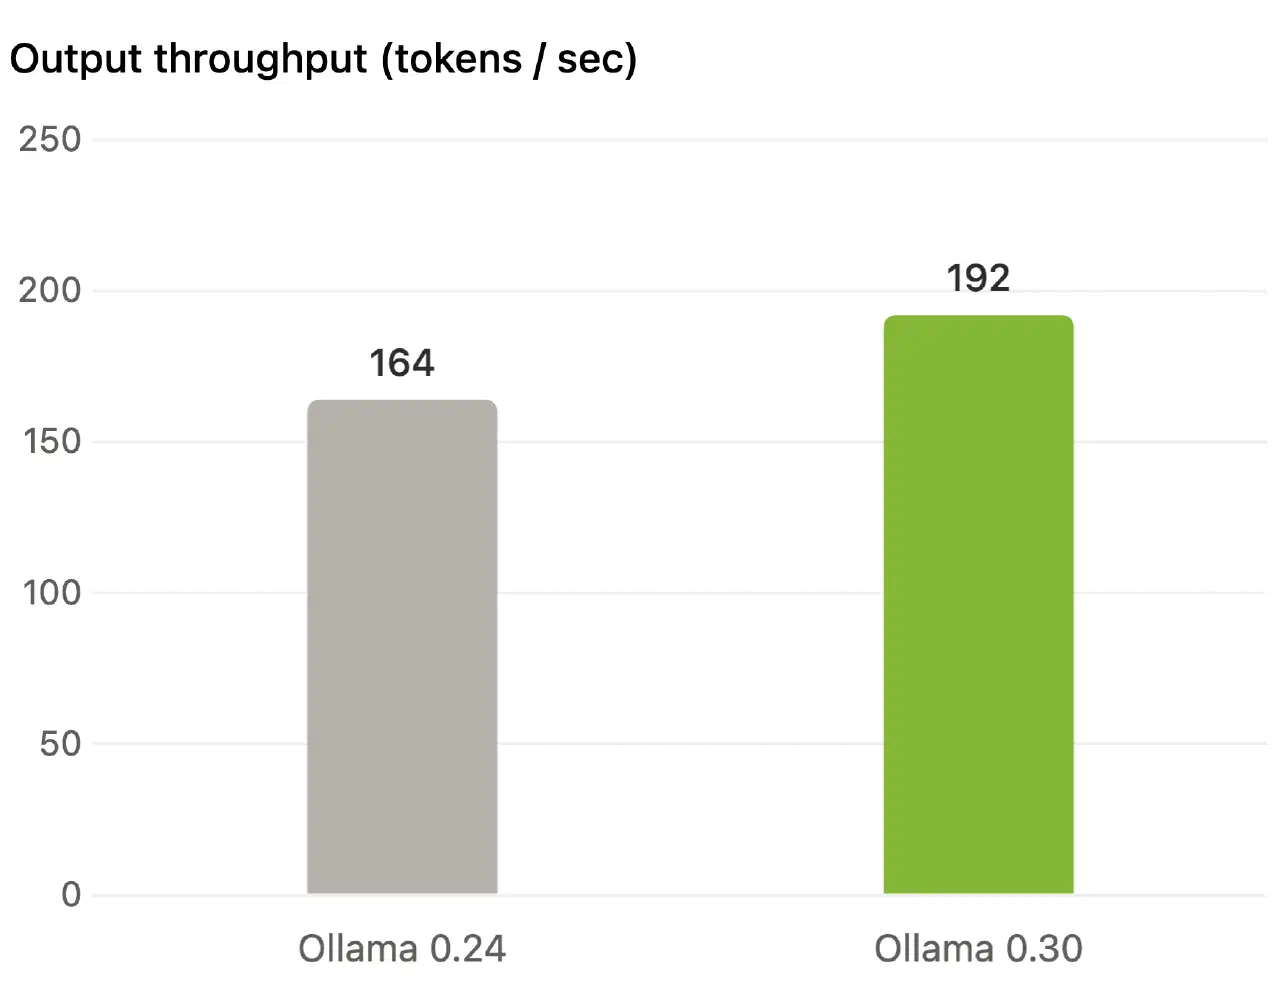
图中吞吐量来自 Ollama 的固定条件对比:Gemma 4 26B、Q4_K_M、NVIDIA RTX 5090,对比版本为 0.24 与 0.30。换模型、量化或设备后,需要重新测量。
把四层问题拆开排查#
| 层次 | 要确认什么 | 典型现象 |
|---|---|---|
| 模型文件 | 文件完整、量化版本正确、分片齐全 | 加载失败、文件无法识别 |
| 模型架构 | 当前引擎支持这类网络和必要组件 | 同样是 GGUF,却有些能运行有些不能 |
| 计算后端 | GPU 驱动、系统和后端匹配 | 可以回答,但实际由 CPU 计算 |
| 运行资源 | 权重、缓存及运行开销有足够空间 | 短请求正常,长上下文失败或变慢 |
分层排查可以避免一看到速度慢就更换量化文件:如果问题是 GPU 没有被识别,下载另一个同等大小的模型未必有帮助。
GGUF 是容器格式,不是能力等级#
GGUF 是用于推理的二进制模型格式,包含模型数据与加载所需的元数据。它便于分发和读取,也允许扩展信息。
因此,“这是 GGUF”不能回答模型是否适合中文问答、是否擅长代码,或者工具调用是否可靠。这些要看模型训练、模板和任务表现。格式就像数据库备份文件的容器:能读取文件,不代表其中的数据结构正好满足你的业务。
量化为什么能省空间#
可以先用一个简化计算建立直觉:假设有 80 亿个权重,每个权重平均只用 4 位保存,那么仅这些权重的理论数据量约为:
8,000,000,000 × 4 ÷ 8 = 4,000,000,000 字节这里的 4 GB 是十进制单位下的简化结果,不是“80 亿参数模型只需 4 GB 内存”的结论。实际文件还涉及额外信息,运行时还需要缓存和工作空间;混合精度的量化也不等于每个权重恰好占 4 位。
量化可以理解为:用较少的表示空间近似保存数值,让存储与带宽开销下降,同时接受一定误差。误差对任务的影响应该通过任务样本判断。日常聊天听起来流畅,不代表复杂代码修改或结构化输出仍然可靠。
建议选择一组自己真的会问的问题:一段 Go 错误处理、一段 Java 接口改造、一条 SQL 分析,再加几个需要严格 JSON 的输出。比较不同量化版本时固定问题和评分方式,避免因为一次回答更长就认为质量更好。
导入一个模型时,先留下可追溯信息#
在下载页面先记录模型名称、发布者、文件名、量化方式、下载日期与文件校验值。这样换机器或排查结果变化时,才能确认跑的是同一个文件。下载“最新文件”后只记住本地别名,会让后续复现非常困难。
单文件导入时,先将 model.Q4_K_M.gguf 替换为已经下载、校验并确认兼容的文件。
# Modelfile
FROM ./model.Q4_K_M.gguf
ollama --version
ollama create local-demo -f Modelfile
ollama show local-demo
ollama run local-demolocal-demo 是本地模型别名,-f 指向导入配置文件。查看模型信息的目的,是确认导入结果及所识别的能力。即使显示工具能力,也还需要用实际工具调用任务检验,不能据此替代业务验收。
导入要求与硬件后端要分别核对#
导入 GGUF 时不会自动量化,需要事先准备好文件。拆分 GGUF 应保留原分片名称,并使用覆盖全部分片的通配符。不要只下载第一片,也不要随意改名后期待引擎自动补齐。
NVIDIA、AMD、Apple Metal 与 Vulkan 各有支持条件。Vulkan 后端默认启用仍以相应组件可用为前提,Linux 可能需要额外安装驱动组件。实际排查应核对操作系统、驱动和具体设备,不能把“支持某品牌”理解成该品牌所有历史产品都兼容。
Ollama 0.30 借助 llama.cpp 扩展了 GGUF 兼容,与 Apple silicon 上的 MLX 路径配合。部署时仍应记录实际安装版本,遇到不同表现先核对版本与日志。
怎样比较性能,才不会被一个数字误导#
本地验收可以分成三个阶段,并分别记录数据。
第一阶段是加载。 观察从未加载状态到模型可用需要多久。它更接近“偶尔使用时等多久”,容易受到磁盘和缓存状态影响。
第二阶段是处理输入。 使用固定长度的提示词,观察长文档进入模型后的等待。代码助手经常读取较长上下文,只有短问题的测试不够代表真实体验。
第三阶段是生成输出。 固定模型、量化、上下文和请求并发,再比较生成速度。记录是否有其他程序占用显存,以及是否发生 CPU 与 GPU 混合运行。
用固定条件记录结果,才能比较两台机器或两套配置:
| 项目 | 机器 A | 机器 B |
|---|---|---|
| Ollama 版本、系统、驱动 | 待记录 | 待记录 |
| 完整模型文件及校验值 | 待记录 | 待记录 |
| 上下文设置、输入长度、并发 | 待记录 | 待记录 |
| 冷加载与首段输出等待 | 待测量 | 待测量 |
| 生成速度与峰值资源占用 | 待测量 | 待测量 |
| 固定任务的正确性 | 待评估 | 待评估 |
如果某个方案生成更快,但结构化参数经常不合法,对业务工具来说可能反而更慢,因为还要纠错和重试。比较时应该同时看结果质量与完成整个任务的时间。
更换硬件之前,还可以先做一个对照:同一个文件、同一个问题,只调整上下文设置,观察等待和内存占用如何变化。随后恢复原参数,再改变其他条件。一次改变多个变量虽然方便,却很难判断效果来自哪里。测试记录里也要保留失败样本,内存不足与加载错误都是部署结果的一部分。
本地部署的第一步可以很小:挑一个明确任务,固定一个模型文件,在现有硬件上跑通并记录。等确认瓶颈属于模型能力、上下文还是硬件后,再决定更换量化、调整后端或升级设备。
参考来源#
- Ollama 团队:Improved performance and model support with GGUF,2026-06-05。
- GGML 项目维护者:GGUF 格式说明。
- Ollama 官方文档:Importing a Model。
- Ollama 官方文档:Hardware support。
- 配图:Ollama 团队,图片出处。