
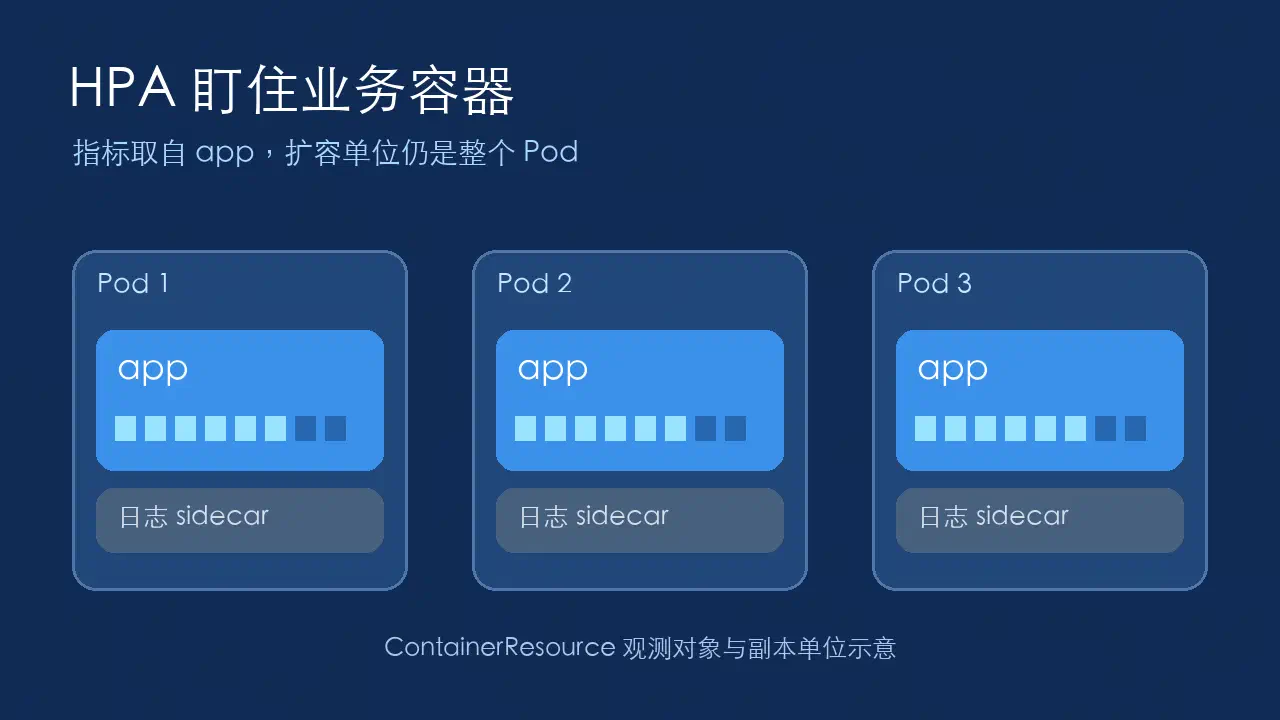
同一个 Pod 里既有业务服务,又有日志或代理容器时,整个 Pod 的 CPU 利用率不一定能准确反映业务压力。扩容前,先想清楚要依据哪个容器的指标,以及增加副本能不能真正分担负载。
选择真正反映业务压力的指标#
基于容器资源的 Pod 自动扩容在 Kubernetes 1.30 成为稳定功能。它允许按指定容器的 CPU 或内存使用情况生成扩容建议,而非仅关注 Pod 汇总值。业务容器与附属容器的负载变化不同,这种区分就有实际意义。
对应的指标类型是 ContainerResource。HPA 调整的是目标工作负载的副本数:选择某个容器作为观测对象,不代表只复制这个容器。
用一组数字看清分母#
假设测试服务每个 Pod 包含 api 和 log-agent,下表数值只是计算示例:
| 容器 | CPU 请求量 | 当前 CPU 使用量 | 相对请求量的利用率 |
|---|---|---|---|
| api | 500m | 400m | 80% |
| log-agent | 500m | 50m | 10% |
两者合计使用 450m,请求 1000m,汇总比例是 45%。如果仅看这个汇总值,会与业务容器的 80% 形成不同判断。并不是监控系统算错,而是它回答了另一个问题。
500m 表示半个 CPU 单位。以请求量为基准的利用率,也不能读成“占宿主机一半 CPU”。
这个例子不意味着业务容器达到 80% 就必须扩容。还要看响应时间、错误率和负载是否持续。如果它是在等待数据库锁,增加应用副本可能增加数据库竞争。指标是触发依据,业务结果才是验收对象。
配置中最容易混淆的三个名字#
下面是用于说明字段关系的完整 HPA 对象,假设目标 Deployment 已存在于测试命名空间:
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: catalog-api
  namespace: demo
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: catalog-api
  minReplicas: 2
  maxReplicas: 6
  metrics:
    - type: ContainerResource
      containerResource:
        name: cpu
        container: api
        target:
          type: Utilization
          averageUtilization: 65
scaleTargetRef.name 指工作负载,container 必须匹配 Pod 模板中的容器名,name: cpu 指资源类型。65 是教学参数,不能直接作为各种应用的最佳阈值。
部署前应在业务容器设置合理的 CPU 请求量。故意把请求量压低,会在同样实际消耗下得到更高的利用率;把请求量抬高,也可能让指标看起来“轻松”。因此,资源申请和扩容阈值应该一起评估,不能靠修改分母掩盖容量问题。
先确认数据能到达控制器#
一份清单被 API 接受,只能证明格式有效。还需要检查指标链路和控制器判断。以下为可在自己的测试环境核对的只读命令示例:
kubectl -n demo get hpa catalog-api
kubectl -n demo describe hpa catalog-api
kubectl -n demo top pod --containers
kubectl -n demo get deployment catalog-api
如果指标显示未知,先区分目标容器名称、请求量、指标服务和权限问题,不要直接把阈值调低。资源指标通常经 metrics.k8s.io 提供,常见实现是另行部署的 Metrics Server;“有集群”不等于“指标链路已可用”。
新增副本后,还要确认它已经就绪并实际接收流量。只有 Pod 数量增加,而新实例一直启动失败或无法调度,应用容量并没有按预期增长。反过来,实例已经就绪但请求仍集中到少数旧实例,也需要继续检查流量分布。
可以按观察到的状态缩小排查范围:
| 观察结果 | 优先核对 |
|---|---|
| 指标未知 | 容器名、请求量、指标链路 |
| 期望副本增加,实际副本没增加 | 工作负载事件与调度条件 |
| Pod 已创建但长期未就绪 | 应用启动、探针和依赖连接 |
| 新实例就绪但接口仍慢 | 流量分配与下游瓶颈 |
这些只是排查入口,不是自动诊断结论。比如 Pod 未就绪可能来自多种原因,应以事件和应用日志解释,不要仅凭 CPU 偏高就认定节点资源不足。
扩容测试不能只截一张副本数图片#
可以设计三个阶段的测试:稳定低负载,持续增加的负载,再恢复低负载。每一阶段同时记录请求量、延迟分布、错误率、就绪副本和数据库连接使用情况。目标是观察容量是否跟上需求,而不是追求扩容动作越快越好。
再加一项有针对性的实验:保持业务请求基本不变,仅增加日志处理压力。如果选择业务容器作为指标,这次变化是否仍会影响实际服务质量?这能帮助判断日志容器是否需要独立资源调整,或者是否已经与业务服务争夺节点资源。
这些实验应在可控环境进行,并事先设定最大副本数与停止条件。扩容上限同时意味着下游压力上限需要重新估算:一个实例最多开多少数据库连接,六个实例合计又是多少,是否还有其他服务共享连接资源。
缩容也需要验收。正在处理的请求是否能正常结束,长连接是否有合适的退出流程,后台任务是否会被多个实例重复领取,都属于应用自身的交付要求。HPA 能调整数量,却不能替业务实现任务互斥或幂等。
尤其是既处理 HTTP 请求、又执行定时任务的服务,扩容可能改变后台作业的并发度。应先把工作职责与任务状态管理说清楚,再验证新增实例的行为;不能只压测一个无副作用的健康检查接口,就宣布整个服务具备弹性扩容能力。
发布时别悄悄改掉指标对象#
如果发布中把容器 api 改名为 server,HPA 清单也需要协同更新。更稳妥的做法是把容器名看作运维接口的一部分,在代码审查里检查部署模板与扩容配置是否保持一致。
同样值得检查的是发布系统是否反复写入固定副本数。如果一边期望 HPA 管理副本,另一边每次同步都把它改回指定值,观察到的抖动可能来自两个控制来源。应明确副本字段由谁维护,并在测试中覆盖一次真实发布流程。
这些交付细节与镜像仓库配置笔记讨论的边界相似:配置写在哪里、由哪个组件读取,比文件表面上写了什么更重要。遇到扩容问题,也应该沿着目标对象、指标来源和实际实例逐层核对。
按运行版本核对功能#
实际使用时应依据所在集群版本查文档,并核对平台提供的指标组件。1.30 已结束上游维护,使用这个功能不意味着需要安装这一旧版本。
对于业务系统,扩容策略最终要证明两件事:观测的确实是想要分担的负载,增加实例后服务确实改善。如果 CPU 曲线好看了,超时和下游竞争却更严重,就应回到请求路径找原因,而不是继续提高副本上限。
参考来源#
- Kubernetes v1.30 Release Team,《Kubernetes v1.30: Uwubernetes》,2024-04-17。
- Kubernetes 文档维护者,《Horizontal Pod Autoscaling》、《Resource Management for Pods and Containers》,动态官方文档。
- Kubernetes 发布维护者,《Patch Releases》,版本维护历史。