
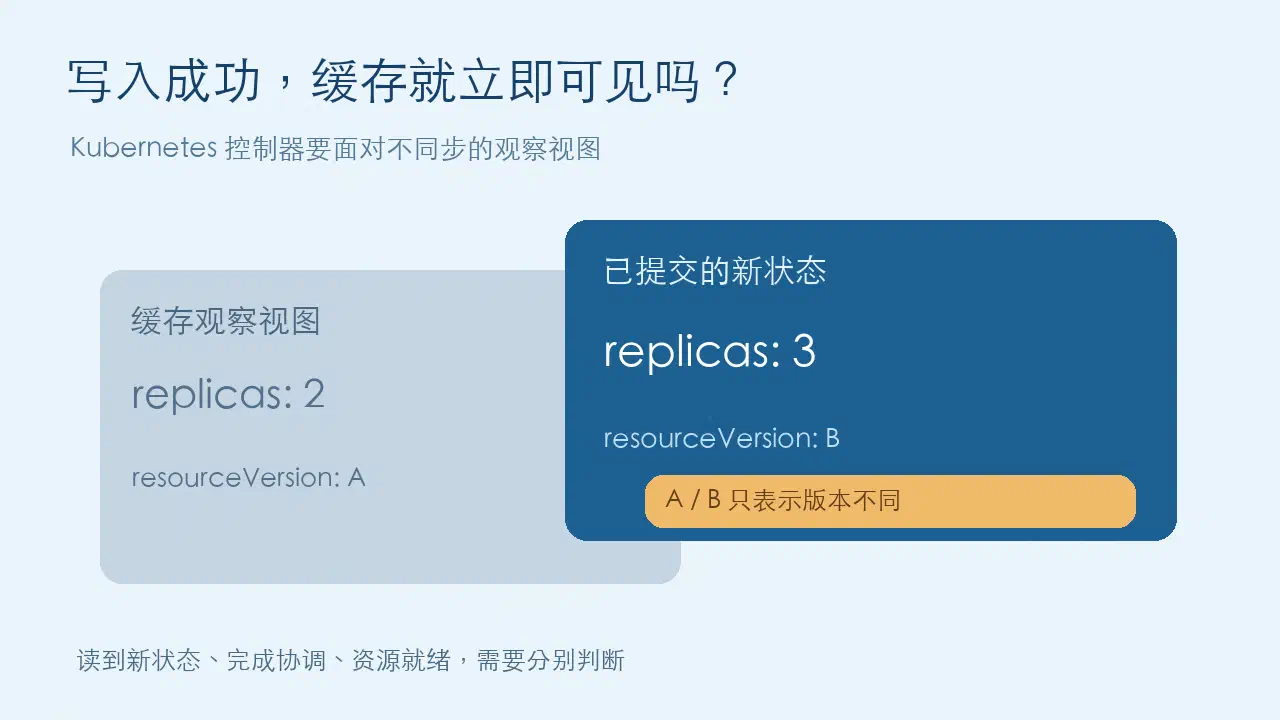
在 Kubernetes 中,“请求写入成功”和“控制器已经从缓存看到新状态”可能不是同一个时刻。排查副本数量、Job 状态或自定义控制器异常时,如果把两者视为同步完成,就容易沿着错误方向检查。
排查时先分清三个问题:控制器读到了什么、它已经写入了什么,以及两者之间的进度是否对得上。
缓存为什么会影响控制器决策#
控制器常通过本地缓存读取集群状态。写入 API 服务后,变更还需要经过监听和缓存处理,才能进入下一轮协调所依据的视图。
Kubernetes 1.36 为 DaemonSet、StatefulSet、ReplicaSet 和 Job 控制器加入了旧缓存缓解能力:如果已知写入尚未被缓存追上,就先暂缓协调。client-go 提供相应的同步进度能力,帮助减少基于旧视图作出的决定。这不等于所有缓存与外部系统已经同步。
控制器一直在做什么#
控制器持续观察状态,推动实际状态接近期望状态。例如,期望运行几个实例,与当前实际有几个实例之间存在差距,控制器便通过 API 请求做调整。
这里至少有三个状态:声明的目标、API 服务接受的资源状态,以及控制器当前观察到的状态。它们有关联,但不能在每一个瞬间都当成同一份数据。
类似的现象也会出现在业务服务中:数据库已提交,而读取缓存尚未更新;支付平台已经接收请求,而本地任务状态还没收到回调。类比有助于理解时间差,但不能照搬同一套修复方式。
用一个简化时序理解“刚写完却没看到”#
假设某个自定义控制器要保证两个工作对象存在,可以把一次缓存延迟简化为下面的时序:
时刻一:控制器从缓存看到一个对象,目标为两个
时刻二:控制器创建第二个对象,API 服务接受写入
时刻三:本地缓存仍暂时只显示一个对象
时刻四:另一轮协调到来,再次判断“缺一个”
时刻五:此前的变更终于进入本地缓存
如果没有去重或进度保护,第二次协调可能重复创建。相反,如果用“正在处理”一律阻止协调,却没有恢复机制,任务又可能长时间卡住。
因此,可靠设计需要同时回答:如何识别自己已经发起的动作,何时确认观察状态已经跟上,以及等待超时后怎样重新判断。只加一个固定睡眠时间,无法证明这些问题被解决。
三类问题不要混在一起#
| 现象 | 需要确认的事实 | 直接重试的局限 |
|---|---|---|
| 本地缓存落后 | 控制器是否已观察到相关写入 | 可能用同一份旧状态再做一次决定 |
| 更新冲突 | 写入所依据的对象版本是否已改变 | 需要重新读取并重新计算目标 |
| 外部动作结果未知 | 请求是否已被外部系统接受 | 可能形成重复业务操作 |
例如,一个控制器负责向云平台申请资源。即便 Kubernetes 内部的缓存一致性改善,云 API 的响应丢失仍可能让申请结果未知。此时应该根据原请求标识查询结果,而不是认为“协调可重试”就意味着所有动作可重复执行。
业务幂等与控制循环的重复运行需要配合,但幂等必须由动作本身定义。查询可以重复,创建、扣款、发布或发消息通常还需要对象键、请求标识与状态记录。
排查时先建立一份对象时间线#
建议先记录对象身份和观察到的动作:命名空间、名称、UID、控制器、相关日志时间,以及当时读取到的资源版本。对象删除后以同名重建,名称相同却可能已经是另一个对象,不能把两次生命周期混为一谈。
下面的只读命令可用于查看已知对象。先确认集群和命名空间,再替换占位符。
kubectl config current-context
kubectl -n <命名空间> get <资源类型> <对象名> -o yaml
kubectl -n <命名空间> describe <资源类型> <对象名>
kubectl -n <命名空间> get events --sort-by=.metadata.creationTimestamp
事件和日志可以帮助还原经过,但事件并不是完整审计记录。看到一次创建事件,不等于知道所有请求与重试细节。若问题来自自定义控制器,还需要检查它的请求日志、队列重试与当前缓存来源。
接下来检查控制器是否健康:是否持续重启,是否卡在外部请求,是否出现访问错误或长时间未处理队列。只有找到缓存跟进存在异常的证据,才把缓存落后作为主要假设。
资源版本不是业务时间戳#
列表与监听通过 resourceVersion 连接起来;历史事件不可用时,客户端需要处理 410 Gone 并重新建立状态。使用成熟客户端的监听与恢复机制,通常比自己维护一套零散轮询更容易保持语义完整。
工程实现中,不要把资源版本随意当作时间戳,或用来自不同集群、不同资源类型的值直接推导业务先后。涉及一致性检查时,应使用所选版本客户端提供的机制,并核对该版本的 API 语义。
旧缓存相关指标可以辅助观察,但不能只看一次增长就判定控制器出错。主动跳过一次基于旧状态的协调,也可能正是保护机制生效。更有意义的是结合等待持续时间、业务是否收敛和错误日志一起判断。
如何验证修复真的有效#
可以给自定义控制器准备三组隔离测试:缓存尚未看到刚创建对象时再次协调;请求超时但外部动作其实已成功;对象删除后同名重建。每组都检查实际动作数量和最终状态,而不是只看协调函数是否返回成功。
测试可以通过可控的假客户端或隔离服务注入延迟,不需要在生产里制造故障。对于平台自带控制器,应先核对集群版本、组件参数和托管平台支持情况,避免因为看到新特性文章就直接更改生产开关。
博客已有在 Kubernetes 部署 PostgreSQL 的笔记。部署之后继续观察状态,是同一条工程链路:配置被接受、Pod 被创建、数据库可连接和业务可恢复,都需要各自的证据。
参考来源#
- Michael Aspinwall:Kubernetes v1.36: Staleness Mitigation and Observability for Controllers,2026-04-28。
- Kubernetes 官方文档:控制器。
- Kubernetes 官方文档:API 概念。