
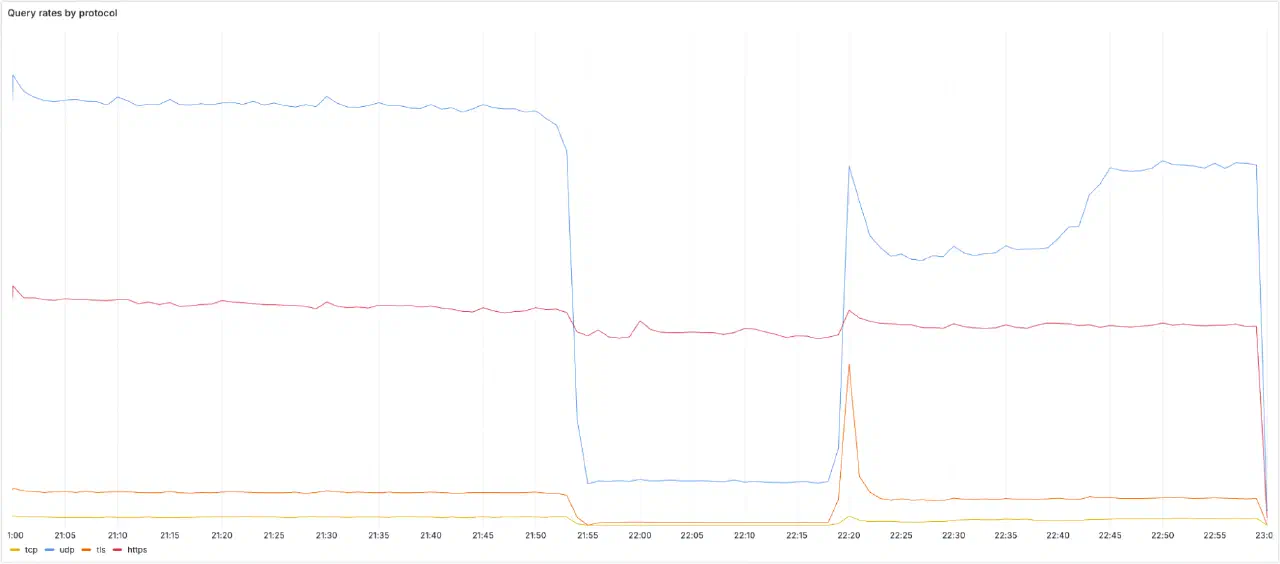
遇到网页打不开,很多人会先换 DNS。但“换了解析器以后能访问”只能缩小问题范围,还不足以解释根因。DNS 进程可能正常,地址也没有变化,只是请求无法经网络到达它。
Cloudflare 的 1.1.1.1 故障说明了这个问题。对 Linux、OpenWrt 和自建服务的维护者,有价值的是分清解析服务、协议路径与路由配置,再用相互对照的结果缩小范围。
路由撤回以后,请求到不了解析器#
2025 年 7 月 14 日,Cloudflare 一次服务拓扑变更触发了此前潜伏配置的生效,导致 1.1.1.1 相关路由从生产位置撤回,造成约六十二分钟中断。根因是内部配置错误,并非攻击或 BGP 劫持。
即使解析进程仍在运行,外部请求失去可用路由后也无法抵达。排查应分别检查服务本身和访问路径。
DNS 服务与去往服务的道路#
可以把一次域名查询拆开看:应用调用系统解析接口,操作系统或本地代理选择解析器,查询经过网络送达解析器,解析器返回结果。任一环节异常,应用都可能表现为“域名解析失败”。
递归解析器与权威服务器也不是同一个角色。前者替客户端寻找并缓存答案,后者负责特定区域的数据。调试时先明确自己检查哪一层,才能避免把递归查询超时误判为域名记录不存在。
例如,某台路由器缓存里已有地址,浏览器还能打开旧页面;另一台刚联网的设备却失败。这种差异可以帮助定位缓存和查询路径,但不证明上游服务对所有用户都正常。
任播让同一个地址出现在多个位置#
Anycast,也就是任播,让多个节点对外提供同一服务地址,路由系统决定请求到达哪个节点。观察结果会受客户端所在网络位置影响,因此监控分布式任播服务需要覆盖不同来源的访问路径。
因此,从家里测试成功,不能推出另一运营商也成功;某个节点上进程健康,也不能代表外部路由都正确。判断服务是否恢复,需要来自实际访问路径的证据,而不能只依赖服务器上的本地健康检查。
自建服务也需要分层检查:容器内访问正常,不代表宿主机端口映射正常;宿主机能访问,不代表防火墙和公网入口正确。每一层都应该有对应的验证入口,才能区分应用故障与路径故障。
用同一问题逐层比较#
固定一个域名和查询类型,先比较 dig 默认配置与指定解析器,避免每次测试都换目标。以下诊断示例需要本机安装 dig,且网络策略允许相应查询。dig 的默认配置不一定等于浏览器或应用的解析路径。
# dig 默认配置的解析器
dig example.com A

# 指定解析器,限制等待时间与尝试次数
dig @1.1.1.1 example.com A +timeout=2 +tries=1

# 对同一解析器使用 TCP 查询
dig @1.1.1.1 example.com A +tcp +timeout=2 +tries=1这里的两秒和一次尝试只是便于观察的参数,不是推荐给所有生产客户端的配置。+timeout 指定等待秒数,+tries 限制尝试次数,+tcp 改用 TCP 查询。结果要记录状态码、是否超时、实际服务器地址和查询时间,不能只抄最后一行。
默认查询成功、指定地址失败,可以继续检查默认路径是否经过本地缓存或代理;UDP 失败、TCP 成功,提示可能存在协议路径差异;两者都失败,还需要区分路由、防火墙、服务无响应等候选原因。
这些比较只能提出方向,不能单凭一条结果给出唯一结论。例如 ping 失败也不能直接说明 DNS 端口不可达,因为 ICMP 与 DNS 的处理规则可能不同。
在 OpenWrt 或代理环境中多检查一层#
家庭网络经常同时存在路由器转发、DNS 劫持规则、分流代理和浏览器加密 DNS。此时应用使用的路径,可能与终端里的 dig 不同。
例如,终端通过路由器的本地解析服务访问,浏览器却使用单独配置的 DoH。两者结果不同,不一定是哪一个工具测错;它们可能走了不同的解析器、目标地址和网络出口。
排查记录可以先写清四件事:客户端是什么、解析器是谁、是否经过代理、使用哪种协议。临时修改配置后重新测试时,也要保留原始结果,避免一边更换 DNS、一边重启代理、一边清缓存,最后无法判断哪个动作起作用。站内的 WireGuard 内网访问记录也可作为理解路由与返回路径的补充入口。
配置提交与配置生效必须分开验证#
一个配置文件通过语法检查,只说明格式能够被解析。实际发布还可能经历模板渲染、控制器同步、节点加载和旧状态清理。每一层都可能让“仓库里正确”与“运行中正确”产生差异。
对于自建网关或服务入口,可以把验收分成三步:检查变更涉及的目标范围;在有限范围确认运行状态;从实际客户端路径测试关键请求。回退也要检查旧配置是否真正重新加载,而不只看版本号回到了过去。
小型系统可以用简单的脚本或人工步骤管理发布,但仍应记录目标范围、运行版本和外部验证结果。操作越依赖手工,越需要在回退后核对当前真正生效的状态。
后备解析器也要检查依赖与规则#
记录问题发生的时间也很重要。网络路径和缓存会变化,半小时前失败的查询与当前成功的查询,未必只相差一个配置动作。保存时间、出口和协议,才能与路由、代理及服务端日志对齐。
后备解析器可以改善某些故障场景,但多个地址可能属于同一运营方,或最终依赖相同出口。内网域名、分流规则和过滤策略也可能不一致,因此不能只把地址数量当作冗余程度。
对维护者,更实用的做法是提前记录正常路径,准备一组固定域名和预期结果,并明确何时允许切换。故障时先保留证据,再做范围可控的变更;恢复后验证原来的内网访问、公共解析和代理行为是否都符合预期。
只有把“解析答案是什么”和“查询如何到达服务”一起检查,才能让一次网络故障留下可复用的判断方法,而不是只记住某个临时有效的 DNS 地址。
参考来源#
- Ash Pallarito、Joe Abley:Cloudflare 1.1.1.1 incident on July 14, 2025;发布:2025-07-15。
- P. Mockapetris:RFC 1034:Domain names — concepts and facilities。
- J. Abley、K. Lindqvist:RFC 4786:Operation of Anycast Services。
- ISC:BIND 9 dig 手册。
- 配图:Ash Pallarito、Joe Abley / Cloudflare,图片出处。